ReviewBench: AI 코드 리뷰를 공개 PR로 검증하는 벤치마크
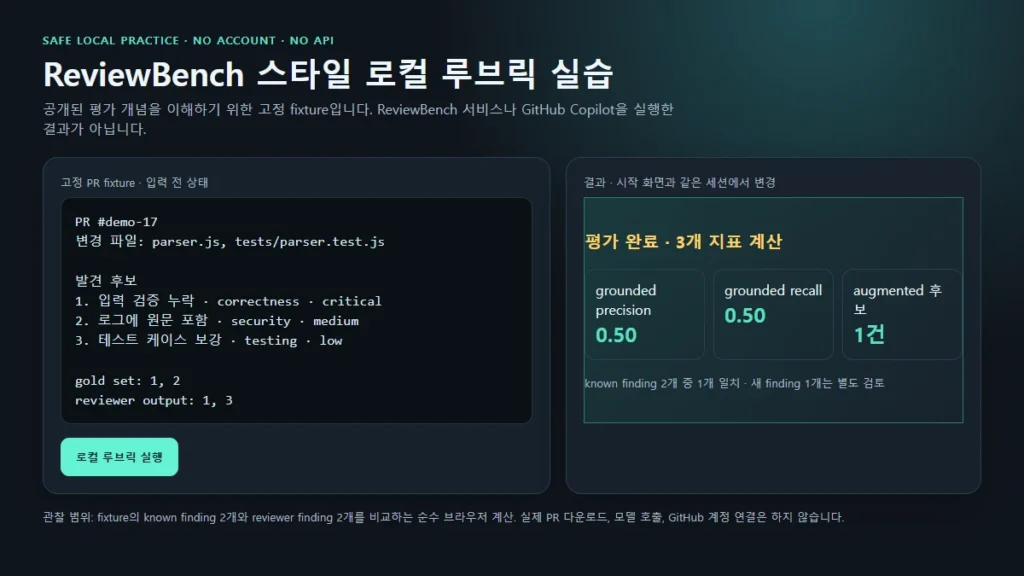
ReviewBench의 공개 PR·gold set·grounded/augmented 지표를 해석하고, 계정 없이 재현한 로컬 루브릭 실습의 범위와 한계를 정리합니다.
MCP와 AI 에이전트의 개념부터 서버 연결, 권한·보안, 도구 호출과 운영 실패 조건까지 직접 검증한 설정과 예제로 설명하는 한국어 실전 자료입니다.
ReviewBench의 공개 PR·gold set·grounded/augmented 지표를 해석하고, 계정 없이 재현한 로컬 루브릭 실습의 범위와 한계를 정리합니다.
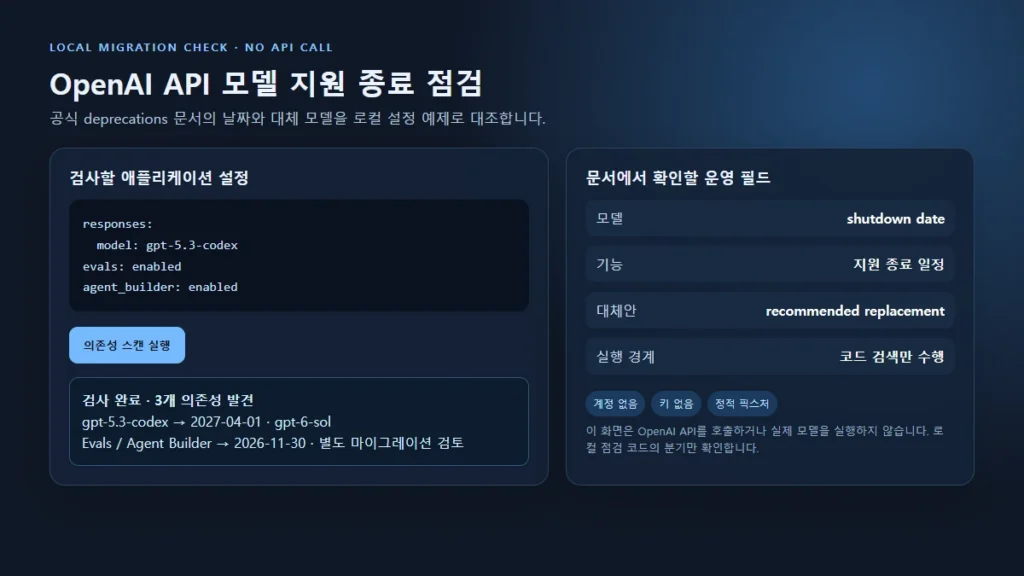
OpenAI API의 모델·기능 지원 종료일을 공식 문서로 대조하고, 실제 호출 없이 코드 의존성을 찾는 로컬 마이그레이션 점검 절차를 정리합니다.
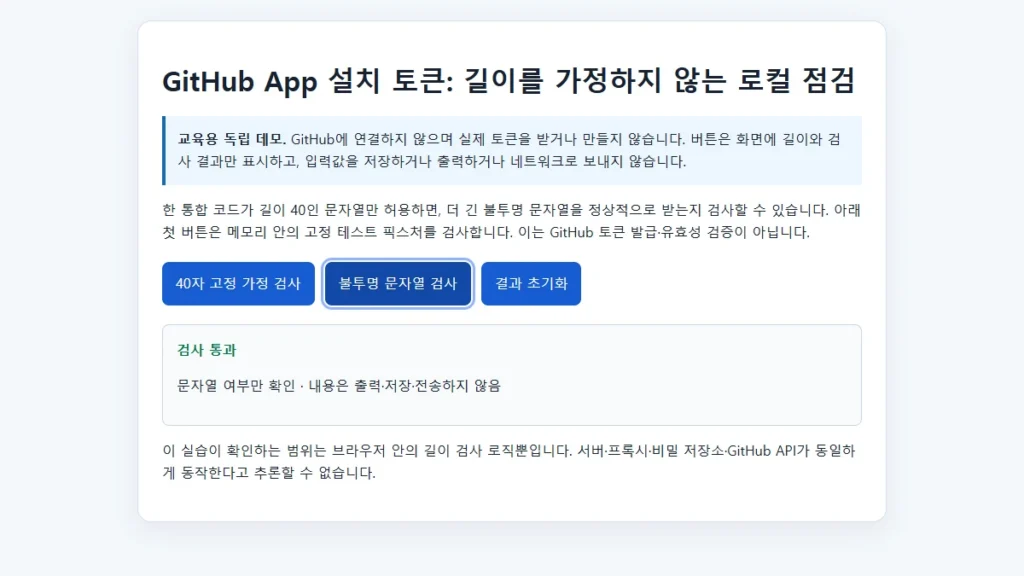
GitHub App 설치 토큰의 40자 고정 가정과 로그·프록시 경계를 실제 토큰 없이 로컬 데모로 점검합니다.
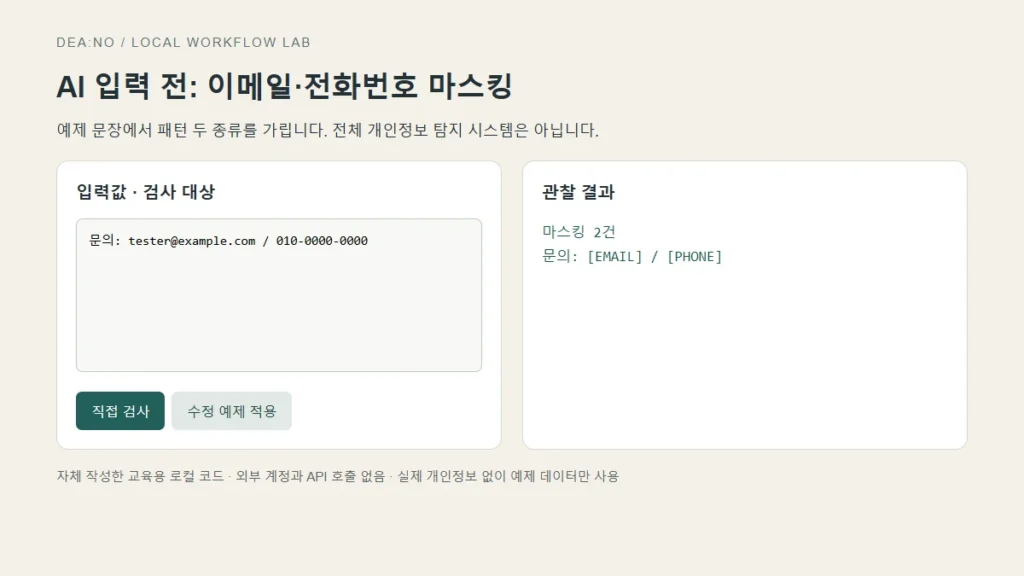
AI 입력 전 예제 이메일과 휴대전화 번호를 로컬에서 가리는 JavaScript 실습입니다. 실제 입력·마스킹 결과·영상과 재현 코드, 탐지하지 못하는 형식, 원문을 로그에 남기지 않는 검수 순서를 확인합니다.
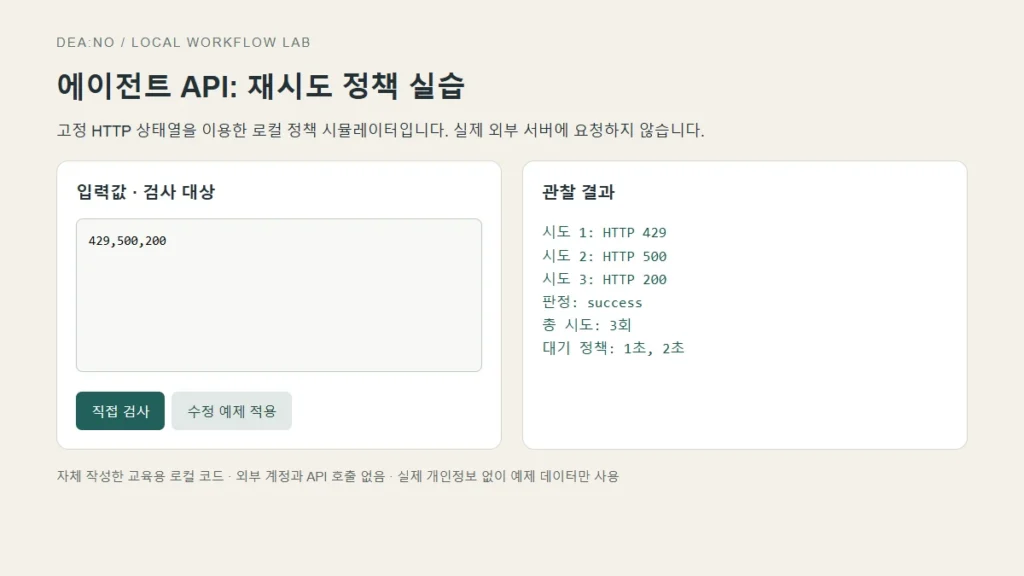
에이전트 API의 일시 오류와 권한 오류를 구분하는 재시도 정책을 로컬 상태열로 검증합니다. 429→500→200과 403의 실행 기록, 실제 화면 영상, 최대 3회 코드와 중복 요청·Retry-After·시간 초과의 한계를 설명합니다.
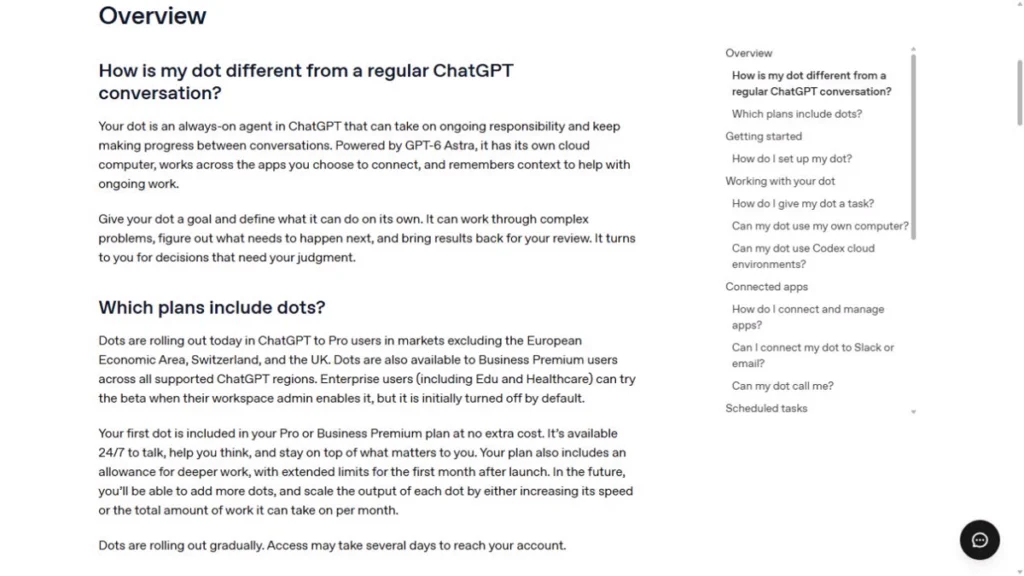
ChatGPT Dots의 최신 활용 사례와 초기 후기를 공식 자료와 대조했어요. 대량 문서 검토·견적 작성·이메일 점검 사례, 업무 지시 프롬프트 3개, 플랜과 사용량·권한의 한계를 구분해 정리합니다.
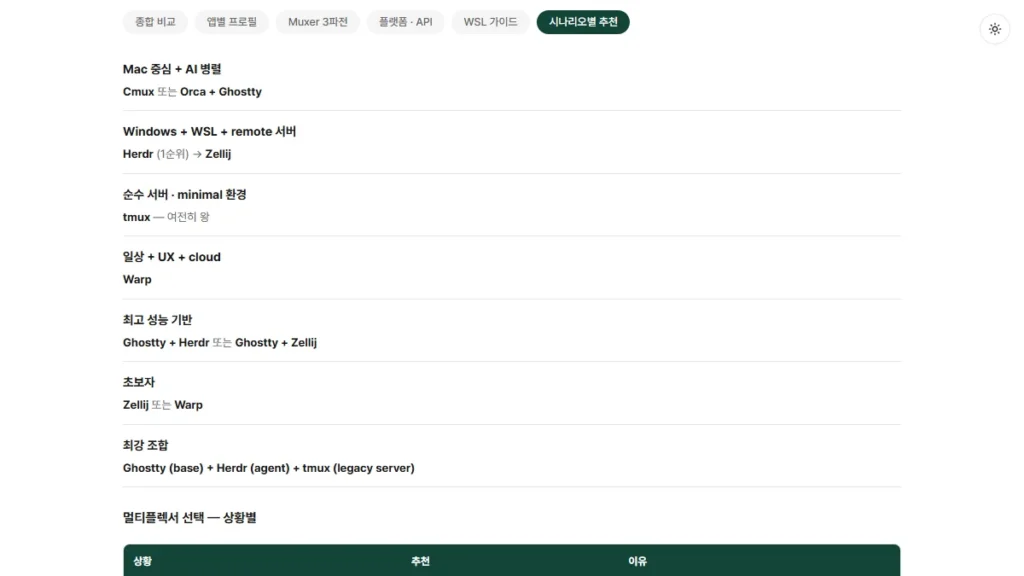
2026년 AI 코딩 터미널 7종을 역할·운영체제·SSH·WSL·에이전트 자동화 기준으로 비교합니다. tmux, Zellij, Herdr, cmux, Orca, Warp, Ghostty의 차이와 상황별 선택법을 공식 문서로 확인했습니다.
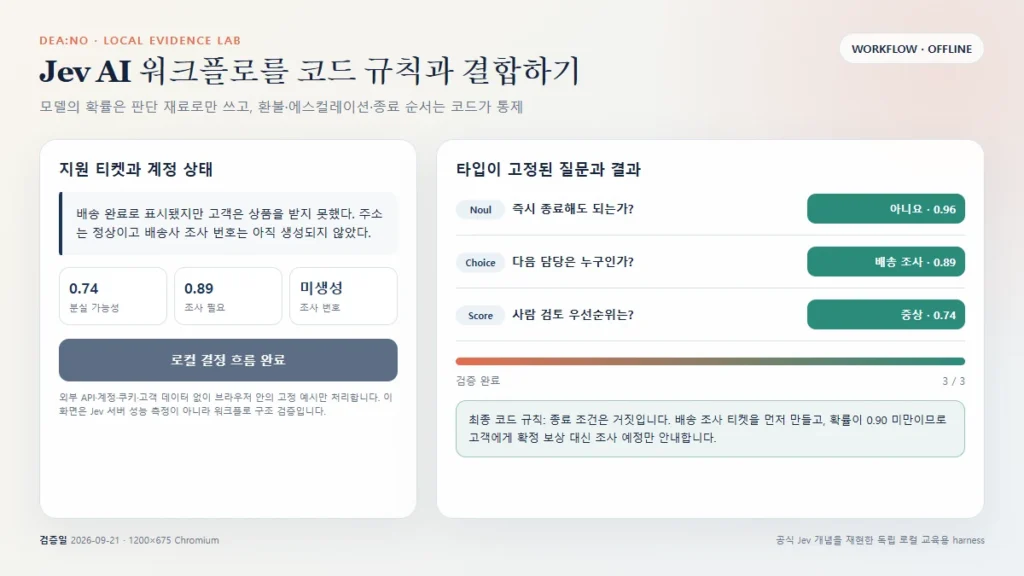
Jev AI의 Noul·Choice·Score 질문을 코드 규칙과 결합하는 방법을 공식 워크플로와 배송 문의 로컬 실행 화면·영상으로 단계별 검증했습니다.
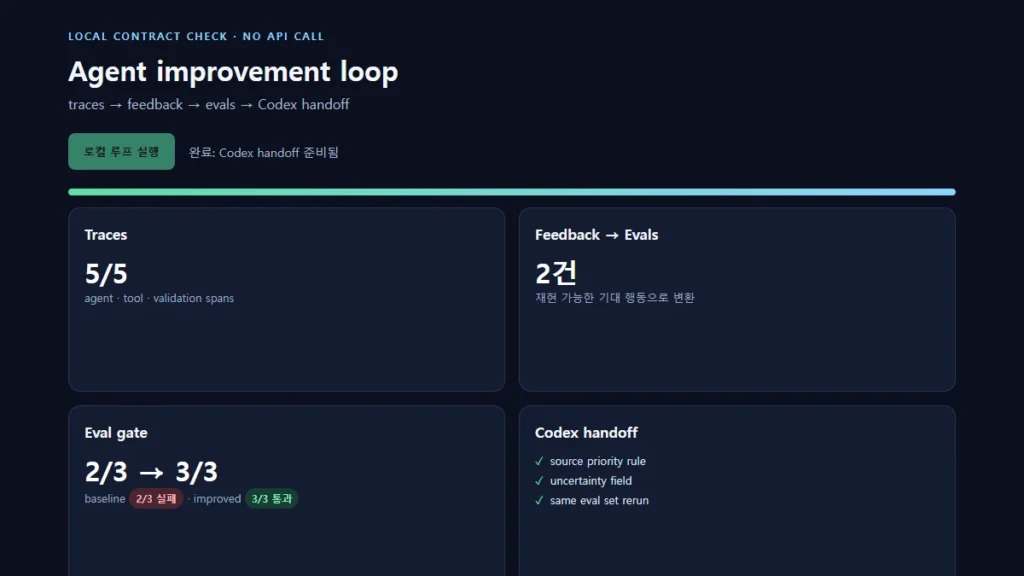
OpenAI 공식 trace·eval 개선 루프를 현재 문서와 대조하고, API 키 없는 로컬 harness에서 feedback과 회귀 게이트를 직접 검증했습니다.
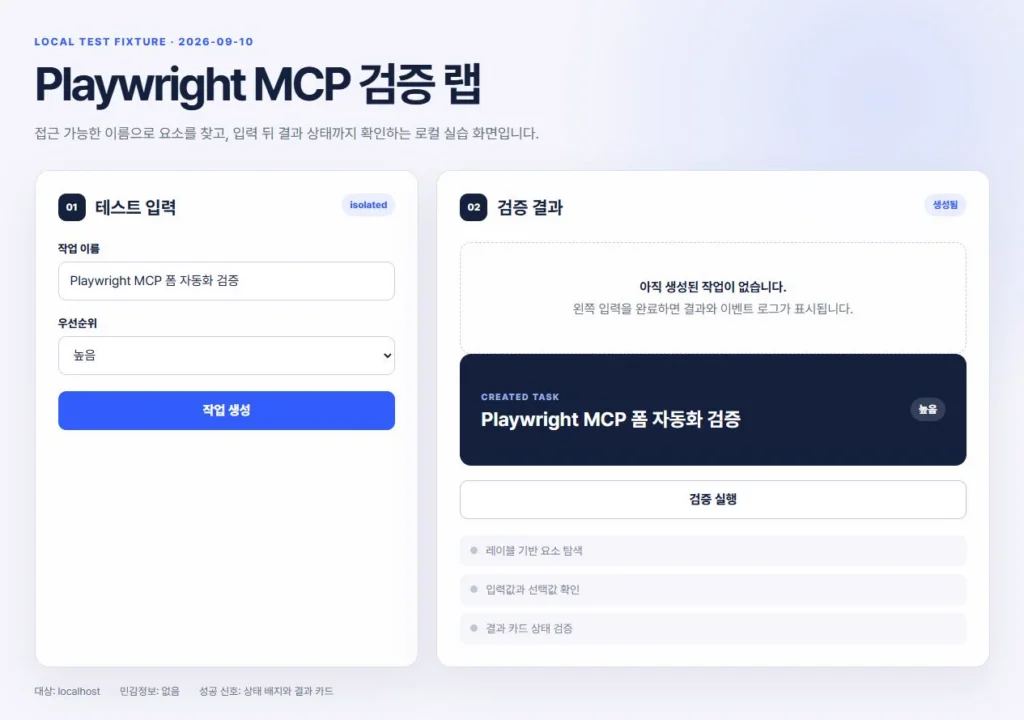
Playwright MCP 설치 조건과 보안 옵션을 확인하고, Windows 11에서 접근성 레이블 기반 폼 자동화를 직접 실행해 실제 화면·작동 영상·실패 조건까지 정리했습니다.