ReviewBench는 공개 PR과 고정 루브릭으로 코드 리뷰 에이전트를 비교하는 기준입니다. 실제 제품 품질 보증서가 아니므로 팀의 회귀 실험은 별도 fixture로 재현해야 합니다.
2026년 10월 7일 기준 GitHub는 ReviewBench를 AI 코드 리뷰 에이전트용 공개 벤치마크로 소개했습니다. 발표 글은 1억 390만 건의 GitHub pull request 분포를 참고해 219개 공개 PR, 187개 저장소, 19개 언어로 구성된 평가 집합을 만들었다고 설명합니다. 이 글의 목적은 특정 에이전트가 최고라고 선언하는 것이 아니라, 벤치마크의 숫자를 읽을 때 무엇이 측정됐고 무엇이 아직 우리 저장소에서 확인되지 않았는지 구분하는 것입니다. 계정이나 API 키가 필요한 제품 실행은 하지 않고, 공개된 개념을 이해하기 위한 안전한 로컬 루브릭 실습만 따로 재현했습니다.
ReviewBench가 해결하려는 문제
AI가 만든 변경을 리뷰하는 도구는 같은 pull request에서도 서로 다른 문제를 찾습니다. 어떤 도구는 심각한 correctness 문제를 놓치지 않으려 하고, 다른 도구는 사소한 유지보수 지적을 줄여 개발자의 소음을 낮추려 합니다. 따라서 “댓글이 많다”거나 “정확도가 높다”는 한 숫자만으로 실제 팀의 리뷰 경험을 예측하기 어렵습니다. 입력 PR의 크기, 언어, 저장소 규모, 발견 항목의 심각도와 범주가 함께 기록되어야 결과를 다시 해석할 수 있습니다.
GitHub 공식 발표는 ReviewBench가 현실적인 PR 분포를 모방하기 위해 대규모 pull request 분포를 분석하고, 단순한 데모 샘플보다 검토 가능한 중간·큰 변경을 충분히 포함하도록 조정했다고 설명합니다. 이 설계는 재현성에 도움이 되지만, 특정 회사의 저장소나 한국어 코드베이스가 동일한 분포를 가진다는 뜻은 아닙니다. 우리 팀의 언어 비율, 생성 코드 비중, 보안 민감도, 리뷰 승인 정책이 다르면 벤치마크 점수와 체감 품질도 달라질 수 있습니다.
또 하나의 핵심은 정답을 한 명의 리뷰어나 한 모델의 의견으로 고정하지 않는다는 점입니다. 사람 리뷰, 후속 커밋에서 추론한 이슈, 정적 분석, 여러 frontier LLM의 후보를 모은 뒤 겹치는 finding을 정리하고 공통 루브릭으로 검증합니다. 이 구조는 “모델끼리 합의했으니 정답”이라는 단순한 계산을 피하려는 시도입니다. 그래도 true positive의 기준은 여전히 루브릭과 검증자에 의존하므로, 데이터셋의 선택·라벨링·grader 버전을 함께 보존해야 합니다.
grounded와 augmented 지표를 나눠 읽기
Grounded precision과 grounded recall은 이미 gold set에 있는 known finding을 기준으로 합니다. 도구가 보고한 finding 중 gold set과 맞는 비율이 grounded precision이고, gold set의 유효 이슈 중 도구가 찾은 비율이 grounded recall입니다. F1은 둘을 균형 있게 합친 값입니다. 이 계열은 같은 PR과 같은 정답 목록으로 두 시스템을 비교하기 좋지만, gold set에 없는 새로운 문제를 잘 찾은 경우에는 충분히 보상하지 못할 수 있습니다.
Augmented precision과 augmented recall은 gold set과 맞지 않는 finding도 별도 판단에 넣습니다. 새로운 finding이 실제로 타당한 문제라면 “정답 목록에 없었으니 오답”으로 버리지 않도록 하는 장치입니다. 대신 augmented 계열은 시스템이 새로 발견한 항목을 어떻게 판단했는지, 어떤 grader와 버전으로 평가했는지까지 읽어야 합니다. 두 지표를 합쳐 하나의 순위를 만들기보다, 엄격한 비교에는 grounded 수치를 사용하고 새로운 발견은 augmented 진단으로 따로 읽는 방식이 안전합니다.
심각도와 범주별 slice도 중요합니다. critical·medium·low를 나누고 correctness·security·reliability·maintainability·testing 같은 범주를 나눠 보면 “전체 평균은 좋아졌지만 보안 finding은 줄었다” 같은 역전이 보입니다. β를 조정한 Fβ는 precision과 recall 중 어느 쪽을 더 중요하게 보는지 반영할 수 있습니다. 운영팀이 원하는 것이 낮은 소음인지 높은 누락 방지인지에 따라 같은 결과의 순위가 달라질 수 있습니다.
직접 실행 결과: 계정 없이 만든 로컬 루브릭 실습
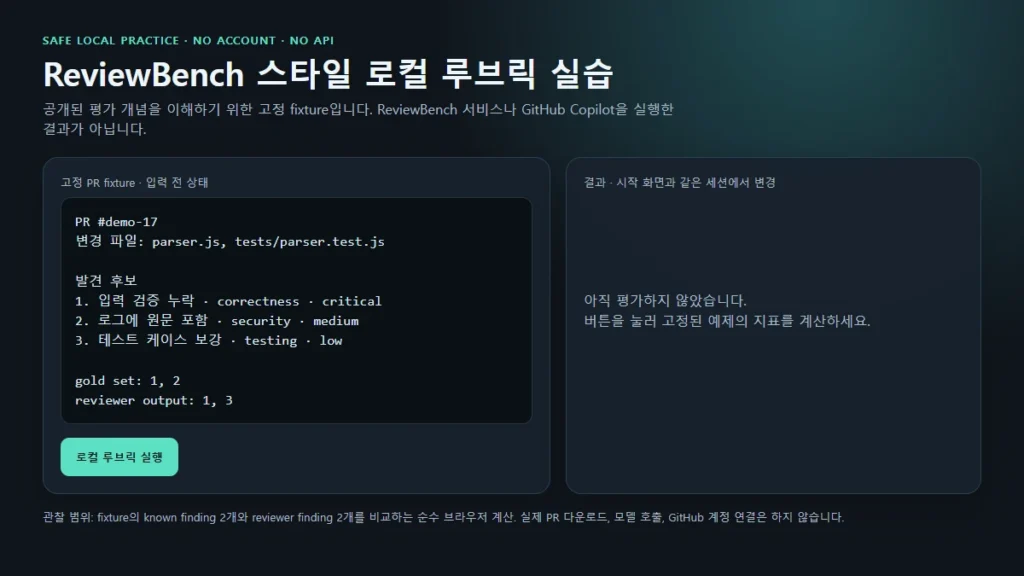
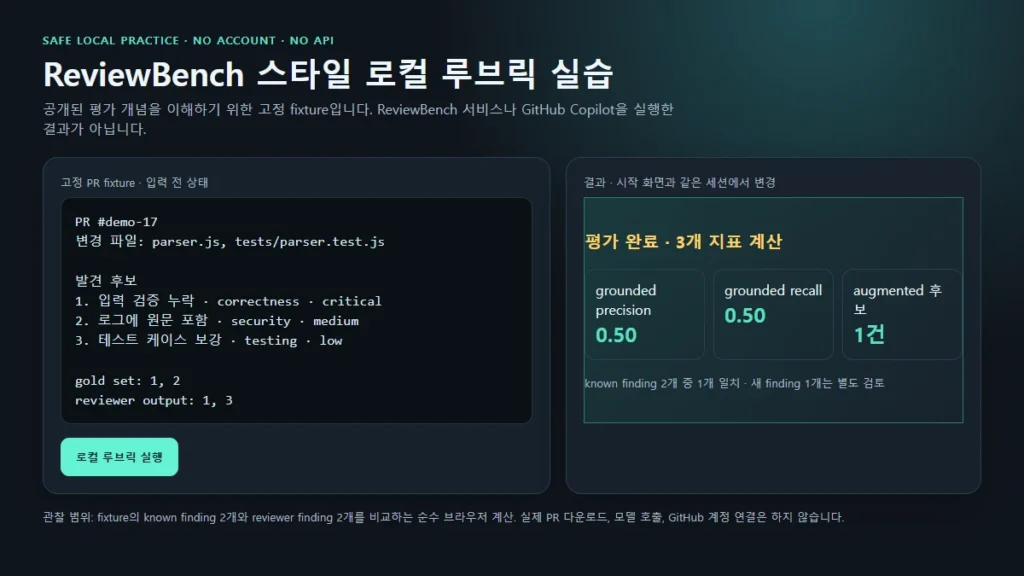
이번 검증 범위에는 ReviewBench 사이트 로그인, GitHub 계정 연결, API 호출, 모델 키 입력이 포함되지 않습니다. 그 대신 공개 개념을 설명하기 위한 자체 작성 HTML fixture에 PR 변경 파일, 세 개의 후보 finding, 두 개의 gold finding, 두 개의 reviewer output을 고정했습니다. 브라우저에서 직접 실행한 로컬 루브릭의 실행 결과는 known finding 일치 여부를 세고 grounded precision 0.50, grounded recall 0.50, 별도 augmented 후보 1건을 표시합니다. 이 실습이 확인하는 것은 “고정된 입력을 지표로 바꾸는 순수한 분류 흐름”뿐이며, ReviewBench 데이터셋이나 GitHub Copilot의 결과를 재현하는 검증은 아닙니다.
검증일은 2026-10-07, 환경은 Windows의 독립 Chromium 1200×675 viewport입니다. 입력값은 고정 PR fixture의 finding 목록과 gold set 두 건이며 조건은 계정·API 키·네트워크 요청 없이 브라우저 계산만 수행하는 것입니다. 시작 화면에는 fixture와 실행 버튼만 보이고, 클릭 후에는 결과 카드와 세 지표가 나타납니다. 관찰 결과는 grounded precision 0.50, grounded recall 0.50, augmented 후보 1건입니다. 전경 창이나 로그인된 사용자 브라우저에 연결하지 않았고, 파일 업로드·PR 변경도 발생시키지 않았습니다. `capture_browser_evidence.cjs`로 같은 세션의 WebP 두 장과 시작→결과를 포함하는 WebM 한 개를 만들고, `capture-session.json`, SHA-256, 재생 가능 여부와 서로 다른 프레임 수를 다시 읽었습니다.
팀 저장소에 적용할 때 먼저 고정할 것
첫 단계는 평가 대상을 고정하는 것입니다. 운영 저장소에서 무작위 PR을 가져오면 개인정보, 비공개 코드, 라이선스, 당시의 변경 맥락이 섞일 수 있습니다. 공개·허가된 fixture 또는 내부 승인을 받은 비식별화 사본을 사용하고, PR의 언어·파일 수·변경 줄 수·저장소 규모·보안 민감도를 메타데이터로 남깁니다. 실행하지 않은 모델이나 제품의 결과를 예시 결과로 쓰지 말고, 어떤 도구의 어떤 버전이 어떤 입력을 읽었는지를 기록해야 합니다.
두 번째는 gold set의 출처를 분리하는 것입니다. 사람 리뷰어의 판단, 후속 커밋에서 확인한 결함, 정적 분석의 경고, 모델이 낸 후보를 같은 열에 섞지 말고 출처와 검증 상태를 보존합니다. 서로 같은 이슈를 가리키는 표현을 합칠 때는 무엇을 동일 이슈로 본 것인지 기준을 남깁니다. security와 maintainability처럼 심각도와 범주가 다른 항목을 한 덩어리로 세면, 점수는 올라가도 운영 우선순위가 왜곡됩니다.
세 번째는 회귀를 한 번의 평균으로 끝내지 않는 것입니다. 같은 fixture에 새 버전을 다시 돌려 grounded 수치와 augmented 수치를 모두 비교하고, critical·security slice에서 누락이 늘지 않았는지 확인합니다. 댓글 수, 처리 시간, 비용, 사람이 후속 조치한 비율을 별도의 운영 지표로 두면 점수와 실제 경험이 어긋나는 지점을 찾기 쉽습니다. 공개 벤치마크는 사전 필터이고, 최종 승인은 팀의 대표 업무와 사람 검토를 포함한 별도 절차로 두는 편이 안전합니다.
마지막으로 네트워크와 권한 경계를 점검합니다. 공개 사이트에 로그인하거나 실제 저장소에 봇을 설치하는 과정은 이번 로컬 실습과 다릅니다. API 키·토큰·비공개 diff가 캡처나 영상에 남지 않는지, 읽기 전용 범위인지, PR 댓글·라벨·브랜치 보호를 바꾸지 않는지 사전 확인해야 합니다. 벤치마크가 “오늘 바로 실행 가능”하다는 뜻이 아니라, 공개된 데이터·루브릭·러너의 범위 안에서 허가된 환경을 준비할 수 있다는 뜻인지 분리해서 써야 합니다.
한계와 실패 조건
이번 결과는 ReviewBench의 공개 PR 219개를 내려받아 실행한 결과가 아니며, GitHub Copilot이나 다른 코드 리뷰 에이전트의 실제 점수도 아닙니다. 로컬 fixture의 2개 gold finding과 2개 reviewer output만 계산했으므로, 0.50이라는 수치를 제품 성능으로 해석할 수 없습니다. 또한 ReviewBench 사이트의 로그인·등록·최종 leaderboard 제출은 수행하지 않았습니다. API 키나 계정이 필요한 경로를 증거 수량을 맞추기 위해 우회하지 않았습니다.
다음 조건이면 평가를 공개하거나 배포하지 않고 보류합니다. gold set의 승인 주체와 버전이 없을 때, 입력 PR의 공개·사용 권한을 설명할 수 없을 때, grader·matcher가 바뀌었는데 이전 수치와 직접 비교하려 할 때, critical/security 누락을 전체 평균으로 숨길 때, 모델 키나 비공개 diff가 캡처·로그에 남을 때, 또는 실제 제품 실행과 자체 fixture 실습을 혼동할 때입니다. 특히 공개된 코드 리뷰 결과가 곧 보안 검증 완료를 의미하지 않으므로 사람의 승인을 없애는 근거로 사용하지 않습니다.
검증 체크리스트
- 공개 PR 집합의 라이선스·범위·언어·변경 규모를 기록했는가?
- gold finding의 출처와 사람이 확인한 기준을 분리했는가?
- grounded precision·recall과 augmented 지표를 혼동하지 않았는가?
- critical·security·testing 등 범주별 slice에서 회귀가 없는가?
- 새 버전, matcher, grader, 프롬프트의 버전을 고정했는가?
- 계정·API 키·비공개 diff 없이 재현 가능한 로컬 smoke test가 있는가?
- PR 댓글·라벨·브랜치 보호 같은 외부 상태를 바꾸지 않았는가?
- 공개 벤치마크 결과와 우리 저장소의 승인 결정을 분리했는가?
비슷한 원칙으로 안전한 자동화를 점검하고 싶다면 이 사이트의 npm stage-only 토큰과 사람 승인 경계 점검 글의 단계·승인·실패 조건 표도 함께 확인할 수 있습니다. 이 내부 링크는 ReviewBench 실행 결과가 아니라, 외부 변경 전에 승인을 분리한다는 운영 원칙을 연결하는 참고 자료입니다.
공식 출처와 검증일
공식 사실은 2026년 10월 7일 GitHub 공식 ReviewBench 발표와 GitHub Copilot 코드 리뷰 개념 문서를 대조했습니다. 발표 글은 데이터셋 구성, multi-source golden set, grounded/augmented 지표와 제출 흐름을 설명하고, 문서 페이지는 코드 리뷰 에이전트가 pull request의 변경을 검토하는 제품 범위와 설정 경계를 확인하는 기준을 제공합니다. 본문에 첨부한 실행 증거는 이 공식 제품의 사용 결과가 아니라, 위 개념을 오해하지 않도록 만든 계정 없는 로컬 실습입니다.